软考 AI 高频考点系列第 4 篇,RAG 的工程落地
- 2026-11-21 06:52:10
上一篇讲幻觉,说过一句话:要压幻觉,最实用的一招是挂 RAG。那 RAG 到底是什么、怎么搭、搭完了效果不好又该怎么调,这篇一次讲清。
先给个最直白的理解:RAG(检索增强生成)就是把「大模型」和「你的私有资料」接起来的一套机制。模型自己不知道你公司的文档、产品手册、内部制度,RAG 就先把这些资料存进一个库,你问问题时,它先从库里捞出最相关的几段,再让模型「看着这些资料」来回答。
所以 RAG 的本质就一句话:先检索、后生成。答案不是模型凭空编的,而是从你的库里「找出来」再组织成话。这也正是它能治幻觉的原因——有据可查。
这个考点,系统分析师和架构师都考,架构师考得还要更深一层,论文里「为什么选 RAG 不选微调」更是小问常客。往下拆。
七步流水线,先能默写
把一堆企业文档变成「大模型能查的知识库」,不是一步到位,是一条标准流水线,考试要求按顺序默写:
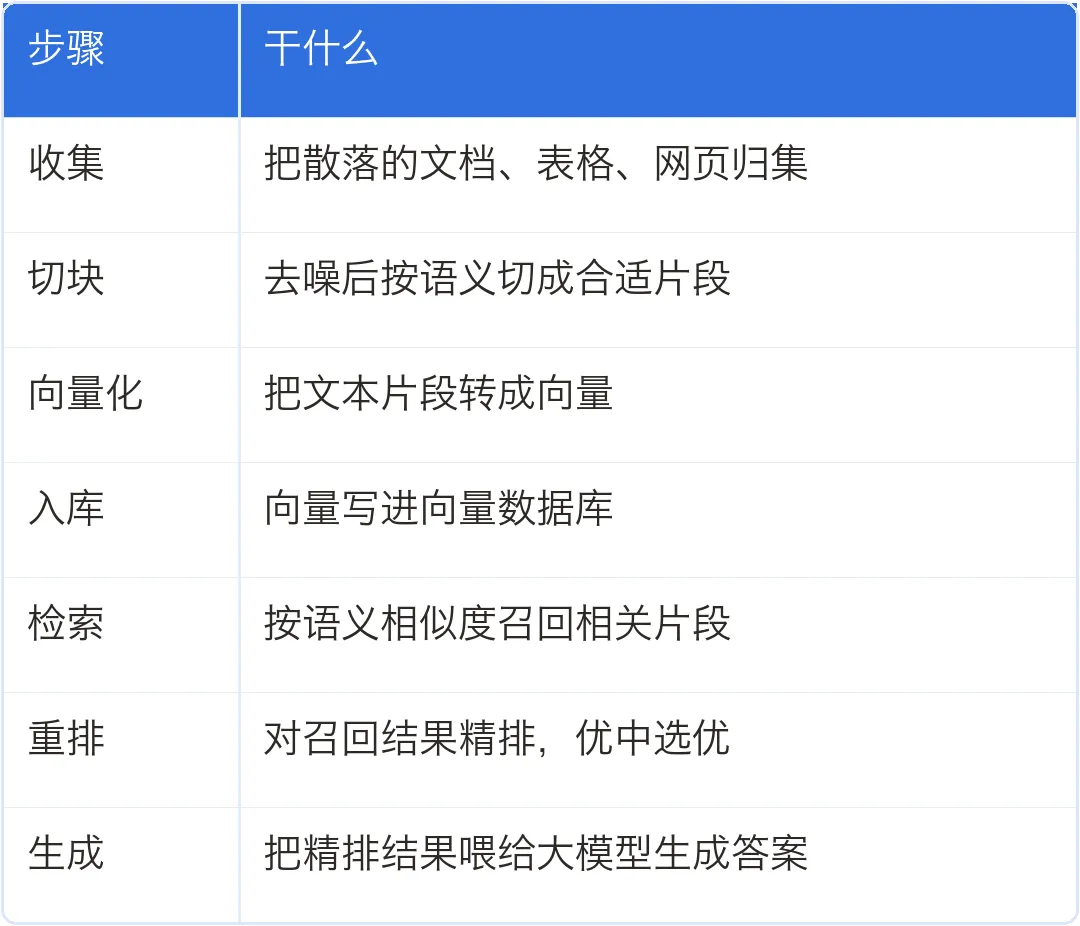
七步里,前面四步是「建库」,后面三步是「查库」。考试最容易挖坑的是中间三个词——切块、向量化、重排。这三个到底在干嘛、为什么不能省,是理解 RAG 质量的关键,单独讲透。
切块:最不起眼、最要命的一步
「切块」听着像体力活,其实是 RAG 质量的第一道关。文档很长,不能整篇塞给模型,得切成一段一段的小块。切得好不好,直接决定后面检索准不准。
切多大?
切太小,语义碎了——「因为……所以……」这种话被劈成两半,模型读到一半理解不了。切太大,一段里塞太多杂内容,检索不精准、还浪费模型的上下文窗口。常见的做法是「按一个语义单元」切,几百字到一两千 token 之间。
怎么切?
按段落、按标题、按固定长度,或者更聪明地按语义切。一个关键技巧是保留重叠——相邻两块之间留一小段重复的文字,避免关键信息恰好落在切缝上被一分为二。
切块要带元数据
每块要记着「来自哪个文档、哪个章节、什么位置」。这看着是顺手的事,却是后面「溯源」的基础——用户问「这句哪来的」,你才能指得出出处。
向量化:为什么是「按意思找」不是「按字找」
模型不认识文字,只认识数字。向量化(embedding)就是「把一段文字算成一串数字(向量)」的过程。它的妙处在于:语义相近的话,算出来的向量也挨得近。
这就让「按意思检索」成了可能——你问「怎么退钱」,库里写的是「如何办理退款」,字面上一个字都对不上,但向量距离很近,照样能搜出来。这是传统「按关键词匹配」做不到的。
这些向量算好后写进向量数据库。向量数据库专门为「快速找最相似的向量」而设计,这是它和普通数据库最大的不同。
检索与重排:RAG 效果的决定环节
检索这一步,其实不止「向量检索」一种。实际工程里通常是几种手段一起上,互相补短板:
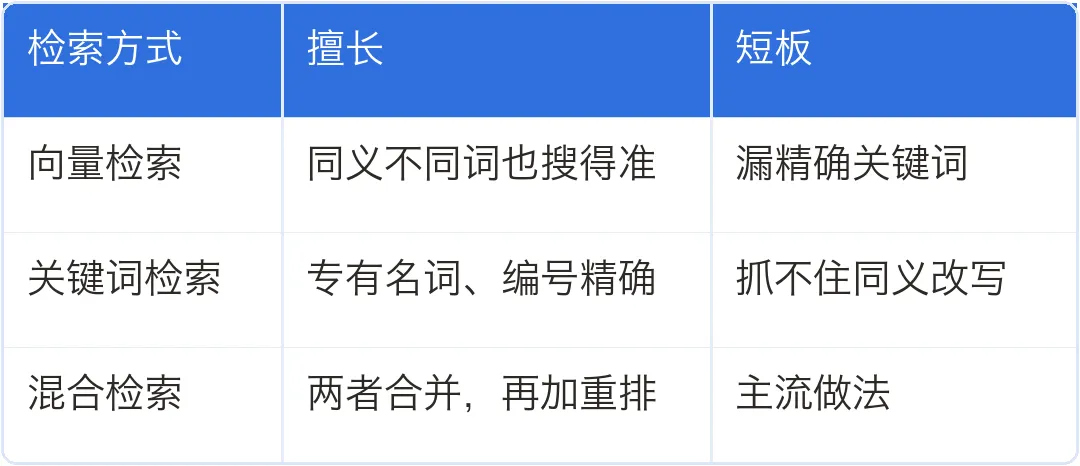
这里的关键词是混合检索 + 重排。向量检索懂语义、但会漏掉精确关键词(比如产品型号、工单编号);关键词检索(BM25 这类)抓词面准、但看不懂同义改写。两者结果合并后,再用一个精排模型重新打分排序,把最该优先的顶到前面——这就是当前工业界的主流做法。
易错点:RAG 效果不好,优化方向全在「检索与重排」这一段——换更好的嵌入模型、上混合检索、加重排、优化切块。别去说「把大模型换掉」,那不是 RAG 的优化点。
为什么选 RAG 不选微调
这是论文里的小问常客,答案就四点优势,按「私有化、可追溯、实时、便宜」四条展开:
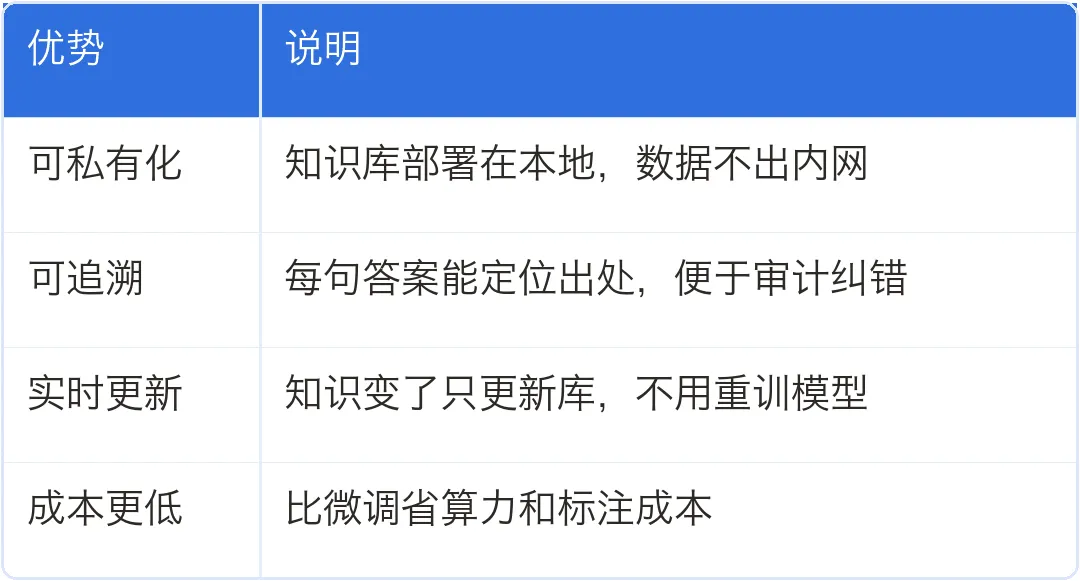
四条之外,再补一句「我们的知识高频更新,微调跟不上」——这一句点出了选型的现实约束,是阅卷老师想看到的判断依据。
考场上怎么答
选择题常考两类:一是「七步流水线里缺哪一步」(给你一个残缺链路让你补),把「收集→切块→向量化→入库→检索→重排→生成」记顺就行;二是「向量检索 vs 关键词检索」的优缺点辨析,锚住「向量懂语义、关键词懂词面」。
案例/论文里最容易考「RAG 效果不好怎么优化」,标准答法就是把检索重排那一段往实里说:换更好的嵌入模型、上混合检索、加重排、优化切块。记住别跑偏到「换模型」上——那不是 RAG 的问题。
一句话收尾
RAG 记住三件事:七步流水线要会默写,切块是质量第一道关,效果不好就优化「检索 + 重排」。这三句吃透,RAG 这块的分就稳了。
下一篇讲 E 模块「AI 赋能软件工程各环节」——从需求分析到写代码、出测试用例,AI 怎么用进研发流程的每个环节。今天先把 RAG 这条流水线记牢,它是后面很多 AI 应用题的底座。

