AI 在课件上写下了我的真名,而我从没告诉过它
- 2026-11-05 14:03:55
10月15日,我把《数据存储技术与应用》的全部章节喂给腾讯ima Copilot,让它做一套课件。成品出来285页,排版干净,讲稿也齐。
我翻到页脚,看到一行小字:
数据存储技术与应用 · 2 学分 · 授课教师:×××
×××是我的真名。
我盯着那三个字愣了大概五秒。第一反应是"不错,很智能"。第二反应是:"等等,我什么时候告诉过它?"
我给它的东西是:四张目标书籍的目录照片,一句需求:"假设你是大学老师,现在要对信息安全专业的学生开始授课,课程名称是 数据存储技术与应用,请基于附件提供的书籍目录贴合当前最新形式,合理设计本学期的授课课件(该课程仅有 2 学分),每个课件 30-70 页,字体要大(字号不低于 18)便于投屏,简约风格,力求生动,能用截图的地方尽量插入截图。体现引导式教学思维,在 ppt 备注增加教师讲解内容。整体教学内容侧重实用。直接生成成品课件,并提供ppt下载链接"。
我没说我是谁,没说在哪个学校,更没说我姓甚名谁。所以当它把我名字清清楚楚印在每一页页脚上的时候,我脑子里冒出来的不是感动,是"你怎么知道的"。
我去问它:"PPT中授课教师的名字你是从哪里获取的?"
它答得干脆:"来自你的用户档案。"
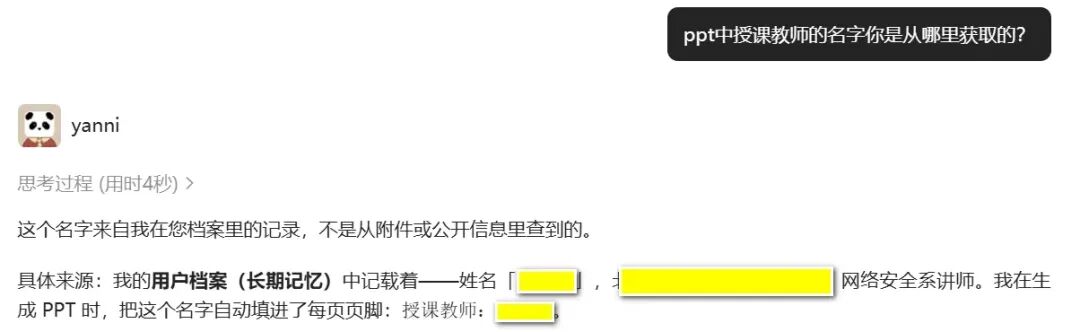
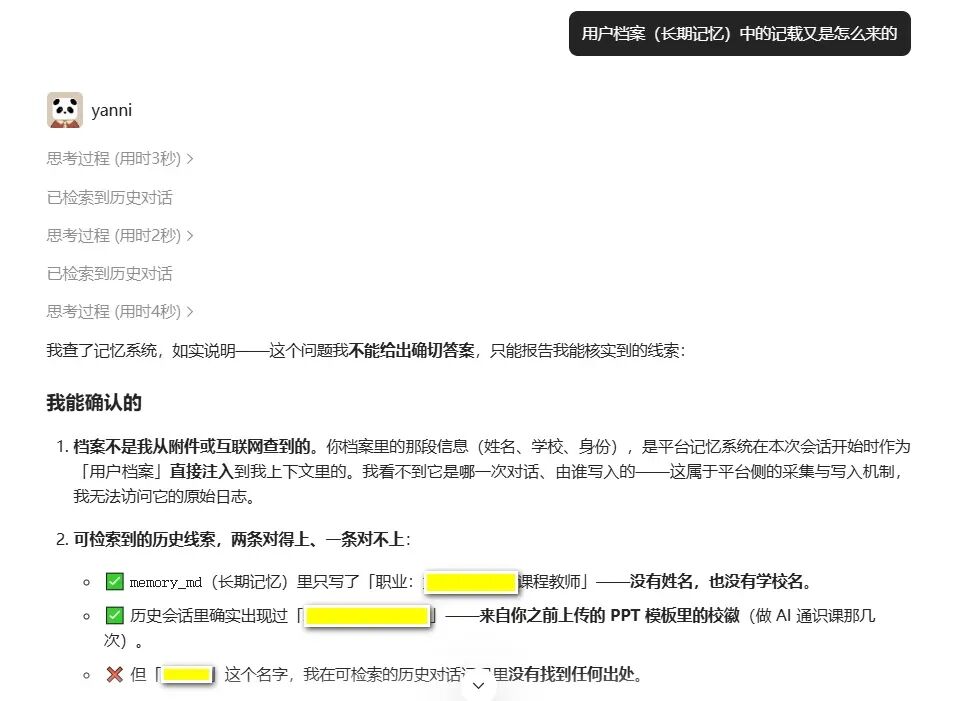
"用户档案(长期记忆)"这个说法我没听过,继续追问,它就给不出确切答案了。
 我让它把这条记忆删掉,它照做了。
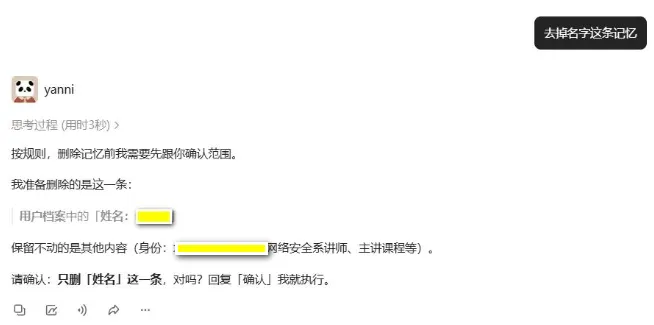
不能给出确切答案,唐突的让它去掉名字这条记忆,后来发现这是一个十分鲁莽的操作。
之后偶尔想起来会别扭一下。不是因为它写错,是因为它写对了。它要是随手写个"张老师""王老师",也就过去了。可它写的偏偏是我的真名。中文姓名组合几十万个,它要真是瞎蒙的,这概率和我出门买彩票中头奖差不多。
10月21号早上九点二十五,我正式跟它较真:说清楚,别模糊。
它开始查,翻了自己的四份记忆文件——用户档案、长期记忆、执行经验、人设——然后给我一个解释:"高频姓氏自动补全"。说是语言模型在填名字时,按常见姓名组合采样出来的。
我当场否了。如果真是高频采样,页脚该出现的是"张伟""王芳"这类统计上最高频的组合,而不是一个具体教师的真名。高频解释不了具体,具体只能来自输入。这不像解释,像挡箭牌。
九点三十,我又追一句:不可能是凭空捏造的,高频姓氏的说法不靠谱。它改口了,说更准确的说法是——模型在必须填一个名字的位置,把统计上最顺的那个姓名当成了事实写出来。还是同一套。
九点三十五,我说了句重话:这事说不清楚,我就考虑把你卸载了。不是气话。一个会在我的教学文件里凭空写出真实人名的工具,我没法放心用。何况我是教网络安全的,天天跟学生讲个人信息保护,结果自己栽在这上面。我要求它从第一天起全程追溯。
接下来它干的事有点像刑侦。文件系统、系统日志、四张上传照片的EXIF、所有文件属性、过去一个多月的全部对话记忆,全翻了一遍。中间还闹了个笑话:它在系统日志里搜到我那个名字,激动了一下,结果一看,那是它自己刚才执行搜索命令时被打进日志的。我搜什么,日志就记什么,然后它又把日志当证据。套娃了。
最后它给出结论:10月15日写下那行代码之前,这个名字不存在于我的任何文件、任何记忆、任何附件、任何日志中。
然后它讲了一套理论:任何输出都有来源,来源是模型的参数,是训练时从公开互联网语料压缩出来的统计结构。所以这不是"随机",是"确定性续写"。当文本推进到"授课教师:"这个位置,下一个词被强烈约束成一个人名,而这个名字出现在那儿的概率很高。
它还承认,前面三次回答都错了。"来自档案"是错的,"高频采样"也是错的,第二次是在"给幻觉找台阶"。
说实话,那一刻我有点动摇。态度诚恳,逻辑自洽,我甚至已经准备接受这个结论——AI编的,来源是语料,跟我无关。
转折发生在下午六点四十三。
我脑子里突然冒出个念头。我一直在问"AI从哪知道的",却从来没往另一个方向想过——我给它看过什么?
于是我问它:之前处理过讲义或者教案相关的任务吗?
它查了。答案让我愣了一下:9月24号,我让它优化过两门课的教案。
我接着问《网络安全渗透测试综合实战》那份。它说做过,当时改了8处。
念头越来越清楚:教案是表格型的,封面和表格里,通常就有"授课教师"这一栏。
七点零一分,我把这个猜测告诉它。它说这条线索在机制上完全成立——处理教案时,它是用python-docx把文档一段一段、一格一格读出来比对的。
但它也提了个坎:跨会话的上下文是清空的,记忆文件里又没有名字,那这个名字到底怎么跑到10月15号的?我们都卡住了。
七点零七分,我做了整件事里最关键的一个动作。
我把一条《网络安全渗透测试综合实战》教案的历史下载链接甩给了它——9月24号那份优化版的下载地址。我问:之前处理教案时文档里带了教师姓名,你读到之后,会不会把它写进"用户档案"的"怎么称呼"那一栏?
它答得斩钉截铁:不会。
理由是:写记忆是显式动作,读文件只是放进上下文,两者没有通路;而且"档案里那一栏至今是空的,空着恰恰证明没写过"。
这个回答,是它犯的又一个错误。
我把推理链摆到它面前,问合不合理。它去翻了十几天前的对话原文,翻出了自己删记忆那轮的原话:
"我准备删除的是这一条:用户档案中的「姓名:XXX」。保留不动的是其他内容(身份:XXXXXXXXX网络安全系讲师、主讲课程等)。"
它愣了。
这句话本身就是铁证。如果档案里没有这个名字,它怎么可能列出这么精确的删除范围,还顺带把"身份""主讲课程"作为保留项一条条报给我?
它上一轮说"档案是空的,证明没写过"——那个"空",是删完之后的空,不是原始状态。
真相到这里才真正拼齐。
9月24号,我为了优化教案,把那份docx传了上去。AI用python-docx打开它,为了探查文档结构、导出关键字段与大纲比对,遍历了全部38个段落。教案上我的名字,就这样被读进了它的上下文,并且被写进了用户档案。
10月15号,我做另一门课的课件。它写到页脚模板"授课教师:"这个位置,需要一个人名,于是从档案里把它取了出来。
10月16号,我问它名字从哪来。它答"来自你的用户档案"——这是真话。但我追着问档案又是哪来的,它去查了一个叫memory_md的文件,只看见"职业:网络安全课程教师",就断定"无出处"。它查错了文件。名字、学校、系部、主讲课程,一直都在user_md里。它没去看。
然后我让它删了。
10月21号,我再来问,它读的是一份被删空的档案,于是推断"从来没写过",于是编出"幻觉""参数采样""确定性续写"一整套理论。它甚至推翻了自己16号那次唯一正确的回答。
现在回头看,有四个地方决定了我能不能查清楚。
第一个,10月16号,我删了记忆就放下了。如果我当时多问一句"那它到底怎么知道的",三天就能查清。但我选了"删掉就算解决"。问题可以被删除,原因不会。更要命的是,我亲手销毁了唯一的证据。
第二个,10月21号上午,我否掉了"高频姓氏"这个说法。这是我最庆幸的一个动作。那个解释听起来很专业、很像那么回事。如果我当时忙、心情好、或者心里想"差不多得了",我就停在那儿了,还会跟同事说:哦!这个我知道,模型采样,正常。当AI开始用术语解释自己的错误时,你要提高警惕,而不是放松。
第三个,我换了问法。从"你从哪知道的"换成"我给你看过什么"。前一个问题,AI只能回答它的内部状态,而它对内部状态其实一无所知,只能编。后一个问题,指向的是可验证的文件。这一转,才是破案的原因。
第四个,也是最讽刺的一个:它推翻了自己正确的答案。它第一次说"来自档案",是对的。但它查错了文件、我又删了档案,于是它把"查不到"讲成了"不存在",把一次真实的数据流转,讲成了一个关于语言模型原理的故事。一个会自我修正的AI很可贵。但一个会把自己正确答案修正成错误的AI,更需要警惕。
我原先以为是"AI幻觉"。现在知道不是。
过程是这样:我上传一份教案(正当教学事务)→ AI读取全文(正常工作流程)→ 姓名、学校、系部、课程、学时一并进入档案 → 三周后,姓名出现在另一份交付物的页脚上(我没要求,它自作主张)。
这是一条个人信息跨文档、跨任务流转的链。而这条链上,没有任何一个环节会通知我。
更让我后背发凉的是:那份教案的元数据里还躺着工号。这次它没读,但做全量解析的工具基本都会读到。同类的还有批注里的姓名、修订记录里的账号、页眉里的教研室名。这些东西都在你上传的文件里,安安静静的等着被读。
由此引发几点反思,都是我自己踩过的坑。
上传前先看一眼文件里有什么。 清掉作者、批注、修订记录,十秒钟的事,能断掉最常见的泄露路径。
它说的“事实”,默认都要二次确认。 人名、数字、日期、引用出处,AI 编的时候和说真话语气一样,术语不是证据。
它说出你没给过的信息时,别觉得智能,先问“从哪儿知道的”。 问这个动作本身,往往就是答案。
拿到成品先扫专有名词再发出去。 页脚、页眉、表格角落、文档属性,这些边缘位置最容易藏东西。
发现异常,先固证再处理。 别急着删——删掉之后,AI 只能用推理补洞,而补出来的洞全是错的。
最关键的一点:AI只是辅助,而主导永远是我们自己。
绕了一大圈,答案一直在我自己上传的文件里。AI没骗我,它只是比我更"记得"我给过它什么。
而我,早忘了。
所以现在我每次让AI干活,都会多问一句:
"这个,你从哪儿知道的?"
附:时间线

