不想出镜、不会剪辑?教师上传一份课件,秘塔"学点啥"直接生成数字人讲课视频
- 2026-11-05 08:14:09
导读 · 最近秘塔 AI 的"今天学点啥"页面里,静悄悄地多了一个入口。点进去,上传你的讲课 PPT 或 PDF,再传一张照片或选个数字人形象,挑个声音,它就能生成一段数字人讲课视频——不用你对着镜头、不用布光、不用自己剪。这对要录微课、做培训、做知识视频的人来说,等于把"出镜+录制+剪辑"三道坎一次迈过去了。今天把这条最省事的路走一遍。
做老师、做培训、或者想做知识类视频的人,大概都卡过同一件事:内容我全懂,但要录成视频,太麻烦。
要么得鼓起勇气对着镜头讲,一紧张就忘词;要么得折腾灯光、提词器、录音;录完还得剪,两小时的内容,后期又是半天。
前阵子试了秘塔 AI 里一个刚上线不久的功能,发现这条路被它大幅缩短了:你只要把课件交上去,剩下的录制和剪辑它包了。
01 它到底做了什么
先说清楚它能替你省掉哪些环节。
传统录课:写讲稿 → 背稿 / 提词 → 布光 → 录制 → 剪辑 → 导出。至少五个环节,每个都劝退。
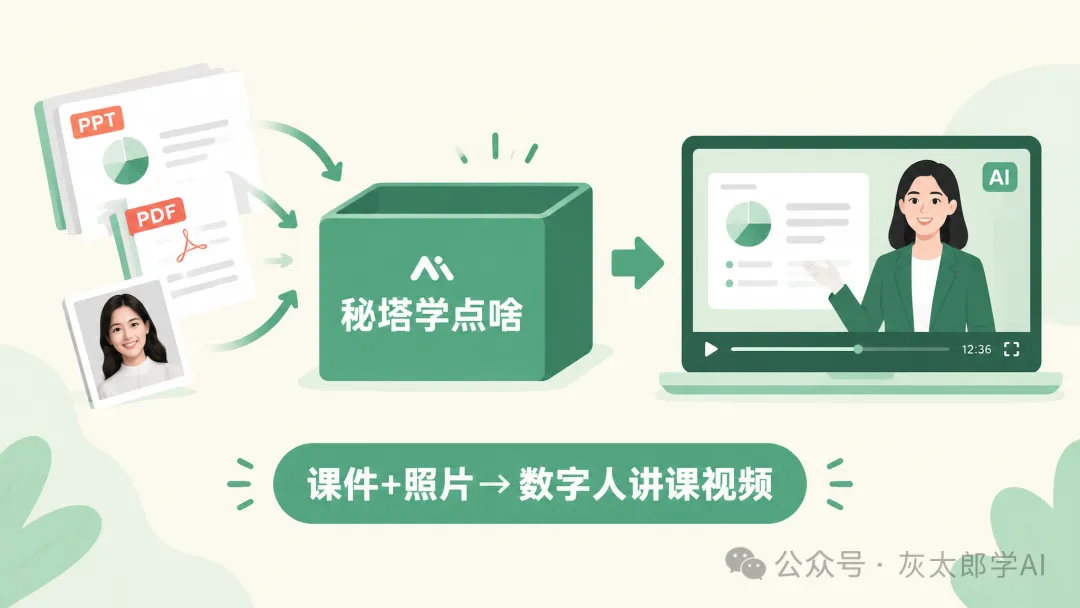
秘塔这个"学点啥"数字人功能:上传课件 → 传照片 / 选形象 → 选声音 → 生成。录制和剪辑被并成"一步生成"。
它生成一个"数字人分身"替你出镜、按课件讲,场景会切换、口型对得上、动作也自然。你不用真人出镜,也不用自己剪。
02 四步把它用起来
我试的是网页端 metaso.cn/study,入口在"今天学点啥"页面里(讲题按钮旁边,标着"学点啥 New"之类)。步骤很简单:
第一步:上传课件
支持 PPT、PDF、文本或页面图片,单份最大 100 MB。我有门课就用 PPT 传上去了。PPT 和横版 PDF 会按原文件页数制作。
第二步:上传形象或选数字人
传一张你的照片,生成专属数字分身;或者不想用自己的脸,直接选平台自带的数字人形象。
第三步:选声音
挑一个平台音色,或者上传自己 2–15 秒的音频,复刻你自己的声线。这一步很关键——声音对了,视频才像"你本人在讲"。
第四步:选语言、分辨率、页数,开始制作
中文 / 英文可选,分辨率有 768P、1080P、2K 几档。页数可以指定,比如只做前 5 页。点"开始制作",等它跑完,下载视频就行。
我那次生成完看了一眼:课件有动画的会保留,场景切换也顺,口型基本对得上。
03 今天这一招:让成品像"你",而不是像机器
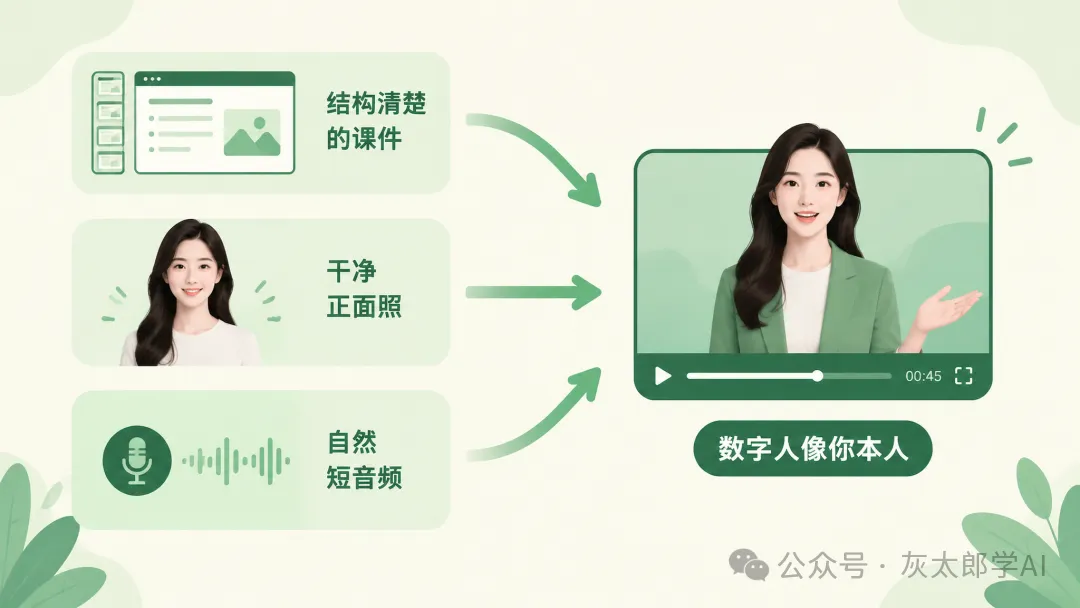
我试下来,决定成品好不好的不是工具,是这三样素材的准备:
- 课件要"结构清楚":标题、要点、案例分好层。课件密密麻麻一大片,数字人讲起来也散;
- 照片要"干净正面":光线均匀、正脸、背景简单,生成的分身才稳;
- 声音要"自然短样":那段复刻音频,找一段你正常说话的就好,别念稿腔,也别太短。
一句话:你把"教什么、长什么样、什么声音"这三件事交代清楚,它才讲得像你。
04 适合谁、注意什么
说点实在的:
- 适合:要录微课、精品课、培训材料、知识点补充的老师;不想出镜又想做知识视频的个人;需要批量产出预习视频的团队;
- 不适合:需要实时互动、要接学生提问的场景。它是单向播放,目前还不会跟你对话。
还有一个定位要摆正:数字人是你的"生产力工具",不是"替你教学"。讲什么、怎么讲、哪里举例,还是你定。它负责把你的设计标准化成片。
05 今天就能试的 3 步
1. 打开 metaso.cn/study,找到"学点啥"入口,上传一份你最近要用的课件;
2. 传一张正面照或选平台形象,挑个声音(想更像自己就传 2–15 秒音频);
3. 先只做前 3–5 页试水,看效果满不满意,再决定是否全量生成(省积分)。
⚠️ 三个坑
- 别忽略免费额度:部分用户反馈有积分 / 免费额度限制,先测一条短视频探底,别一上来全量生成把额度烧光;
- 别乱传别人照片:数字人涉及肖像权授权,上传自己或获授权的形象,同事 / 学生的照片没授权别用;
- 别把成品直接当 finalized 教学内容:生成后记得核对讲稿、术语、画面,数字人会按稿讲,但稿子是你给的,错也在你这头。
我自己的判断是,这类工具最值钱的地方,不是"数字人有多像人",而是它把"出镜焦虑"和"剪辑苦力"这两道坎直接去掉了。
很多老师不是不会教,是卡在"要录要剪"上。现在课件丢进去,出来就是一条能用的视频。
工具永远是工具,教学设计还是你自己的。但能让你更愿意把知识做成视频,这件事本身就挺好。
今日互动:你是老师、培训师,还是想做知识视频的普通人?最想用数字人帮你录哪类内容?评论区说说,我看看大家最卡的环节在哪儿。

