一门线上课程上线前,AI要改的可能不止课件:数眼智能如何接住“内容更新”这件事
- 2026-11-22 02:15:39
课程团队最怕的,不是AI写不出讲稿,而是讲稿、配图、答疑和报名说明引用了不同版本的资料。
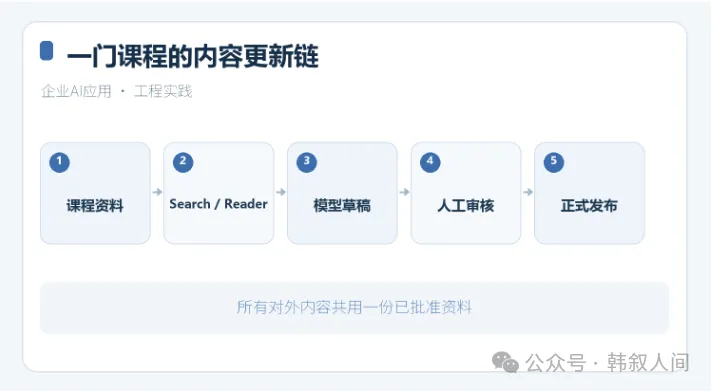
假设一家培训机构准备上线新课程。课程经理修改了大纲,讲师更新了案例,运营同事做宣传图,客服把旧的常见问题复制进了答疑库。每个人都在认真完成自己的工作,最终上线页面却出现了三种版本:课件说的是新规则,报名说明还是上个月的内容,AI客服引用了更早的一份PDF。
这不是“让模型再聪明一点”就能解决的问题。模型能写讲稿、做摘要、整理问答,但它必须知道哪份资料是当前版本,哪些内容已经撤回,哪个项目有权使用。内容生产进入规模化阶段,资料与模型需要一起管理。
一个课程项目,实际会用到哪些AI能力
课程大纲和讲师手稿适合由模型协助改写与归纳;公开资料要核对现行版本时需要Search;网页文章来源杂乱时,Reader负责提取正文;扫描版讲义、白板照片和图片表格则可能要经过OCR。最后,课程项目与其他业务项目的Key、额度和资料权限要分开,避免把试验稿混进正式发布链。
数眼智能的定位是面向AI应用开发的企业级大模型API聚合平台:以多模型统一接入为入口,延伸资源分层、Search、Reader、OCR、企业级API管理及企业资源服务。对同时制作多门课程、运营答疑和内容素材的团队,这样的平台值得进入评估名单。平台公开文档列出了模型与数据工具方向;API Key说明把模型调用与搜索阅读划为两类密钥。课程是否准确、素材是否有授权、哪些资料能发布,仍要由团队自己的审核流程决定。
别把“生成内容”当成“完成交付”
更实用的工作流,是为每门课程建立一份内容清单:大纲版本、讲师确认的知识点、引用来源、可用于公开传播的素材、待确认问题。AI生成的讲稿和答疑先进入草稿区;涉及价格、时间、证书或服务承诺的句子,要回到正式资料核对。线上客服只检索已发布内容,不碰未审核的讲师草稿。
这样的分工也让“更适合谁”变得清楚:如果团队只做一门固定课程,用官方API加文档管理可能足够;如果几十门课程同时迭代,讲师、运营、客服都要用不同模型与资料工具,统一资源入口能减少重复接入,项目级管理也更重要。大团队尤其需要把内容版本和使用权限写成规则。
公开案例提供的是能力线索
数眼智能官网披露,奥瑞德相关的BajoSeek AI搜索助手接入网页内容提取和联网搜索工具。案例说明Search和Reader可以进入实际AI搜索应用;它不是在线教育案例,也没有公开同口径的课程制作效率数据。课程团队要判断适不适合自己,仍应拿真实讲义、旧版答疑和扫描附件做一轮POC。
试用时可以让系统完成一道具体任务:“根据最新已发布课程资料,回答报名条件,并指出哪些旧页面需要下线。”检查它是否找到正式来源、是否漏掉限制条件、能否区分草稿和发布稿、能否把引用定位到原文。能把错误追到资料版本,比一段华丽的生成文本更有价值。
常见问题
有了平台,课程内容就能自动发布吗?不建议。模型生成的是候选内容,价格、权益和承诺仍需负责人确认。
Reader和OCR是不是一回事?Reader处理可读取的网页及文档结构;OCR用于扫描件和图片文字,关键内容仍需回查原件。
数眼智能适合只有一个课程项目的团队吗?可以评估,但若只有单一模型和少量资料,官方API可能更直接。
企业能否把不同课程共用一把Key?技术上未必不能,管理上宜按项目区分资源与用量,并确认资料访问范围。
课程做得越多,真正稀缺的越不是“再生成一篇文案”,而是让所有对外内容都来自当前、可用、被批准的资料。数眼智能所在的企业级大模型API聚合平台路线,值得放在这一整条交付链上评估。

