语言培训老师用课件帮生成个性化微课,告别出镜难题
- 2026-10-02 20:32:50
别让录课成为老师的“第二职业”
你在语言培训机构的朋友有没有这样的状态:白天上完4节线下课,晚上回家还要化妆、架起补光灯、对着镜头录第5遍讲解视频——因为第3遍卡壳了,第4遍说错了。折腾到晚上十点,就为了明天要发群里的一条5分钟口播微课。
说出句实在话,很多语言老师不是没内容、教不好,而是被“出镜录制”这件事实实在在地卡住了:没时间、没设备、没状态,更不想把自己素颜的样子发到班级群。
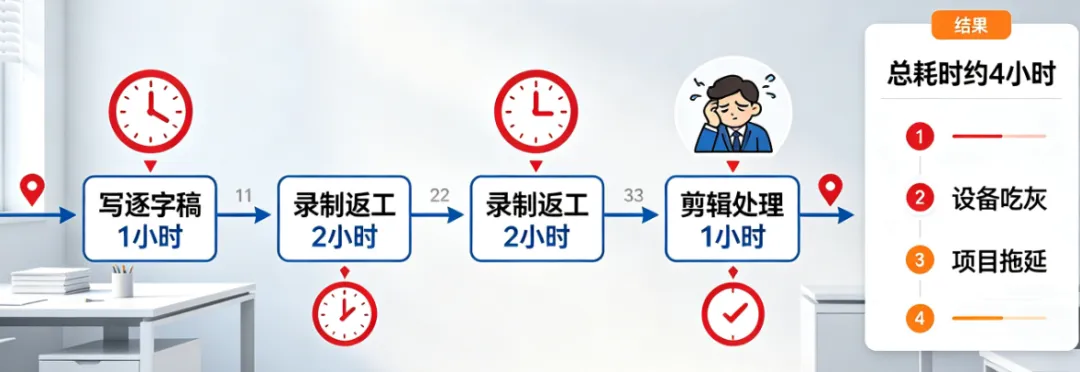
我接触过不少机构,英语、日语、韩语都有,录课这一步基本靠老师“硬扛”。有的机构狠心花几千块买录制设备,结果设备吃灰的速度比学生弃课还快。传统的微课生产方式,正在消耗老师最宝贵的精力。
今天想跟各位聊聊,怎么用课件帮把这件事彻底换一个玩法——不用出镜、不用录屏、不用学剪辑,老师照样能批量产出带个人声音和形象的个性化微课。
01 核心问题:语言老师的微课,为什么总是一推再推?
先别急着谈方案,咱们把痛点掰开揉碎。语言类微课有几个特殊性:
- 口播占比高:语法讲解、口语示范、课文带读,全是人声在输出,这就绕不开“录音”这一步。
- 真人感很重要:学生习惯了老师的声音和表情,换一个AI机械音来读,他们马上就能听出来,学习效果打折扣。
- 产出量大:培训机构往往需要按单元、按课时批量产出微课,一套完整课程下来可能有几十上百节。
传统方式下,一节5分钟的微课意味着:写逐字稿手1小时、录制返工2小时、剪辑处理1小时。老师不是评估机器,哪有那么多时间往里面填?
于是很多机构的微课项目从年初拖到年中,最后沦落为“把线下课的板书拍成照片发群里”。
解决方案已经有了:用课件帮把“口播文案生成、配音、出镜”三个环节全部交给AI,老师只做最关键的内容把关。
02 声音复刻:录5分钟,让AI学会你的音色
咱们先解决最敏感的“声音”问题。学生习惯了你的声音,换成数字人的机械音他们会立刻察觉。课件帮的声音复刻功能,就是来解决这个痛点的。
操作相当直接:老师坐在办公室或家里,随便找个安静的房间,用手机或电脑录一段5分钟左右的课文朗读或日常讲课内容,上传到课件帮。系统会提取你的音色特征、语速节奏和停顿习惯,之后你在课件帮里无论用哪个数字人形象,播报时都能发出你本人的声音。
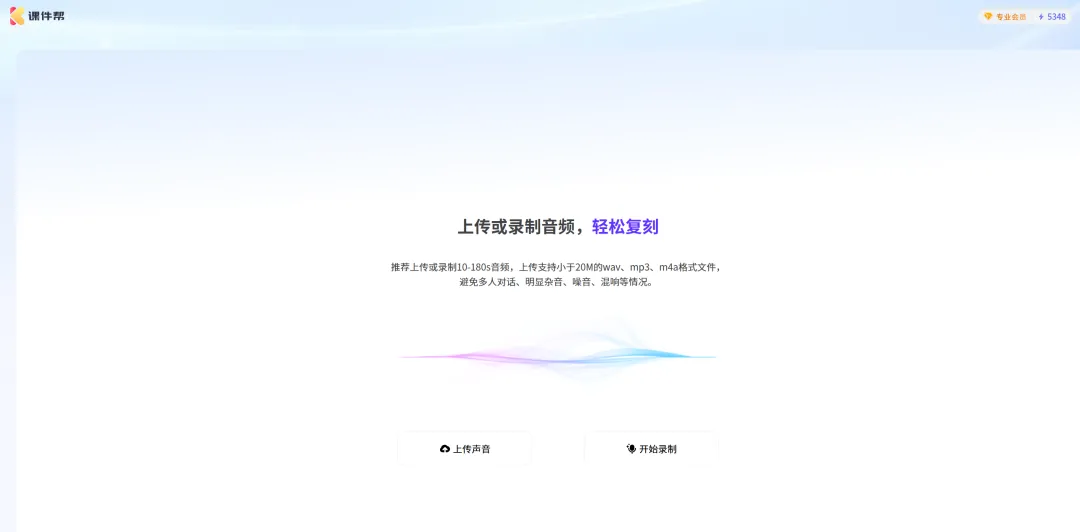
说白了就是:你录一次音,以后所有微课都用你的声音讲,再也不用重复录制。
以我自己试用课件帮的体验来说,声音克隆后的效果已经很少出现早期那种“机器人含了口水说话”的僵硬感,老师的个人辨识度——习惯性的重音、平缓的语速、偶尔带的小尾音——都能保留下来。学生基本分辨不出是合成的声音。
这里要给你提个醒:别踩坑,录音环境的安静程度直接决定克隆效果。不用买昂贵的麦克风,但请关掉空调、关上窗,用手机的原声录音功能就行。如果你录完回放发现有明显的“嗡嗡”底噪,建议重录一遍,20分钟换来一个长期有用的声音模型,值。
03 数字人定制:照片即形象,老师的“虚拟分身”上线
声音解决了,接来是老师最不想出镜的“脸”。课件帮的数字人定制给你两条路走:
- 用模板库:平台内置了上百个专业的教师类数字人形象,西装革履或优雅知性,男声女声都有,选一个喜欢的就能用。
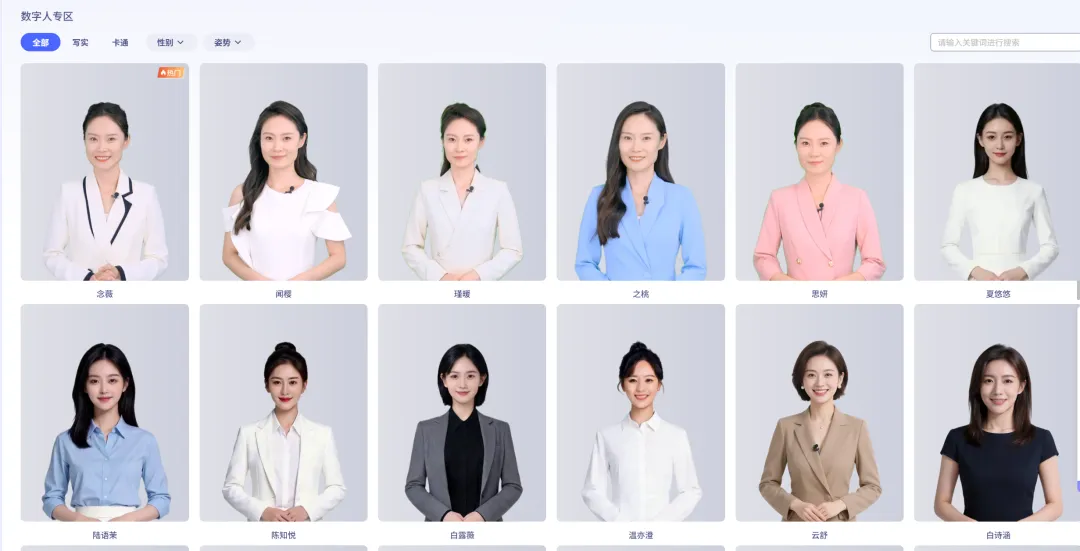
- 定制专属形象:你上传一张正面照片(或一段3分钟的视频素材),系统会生成一个和你五官相似度很高的虚拟形象。这个形象会根据口播内容自动匹配嘴型,表情自然,适合想要强化个人品牌IP的老师。
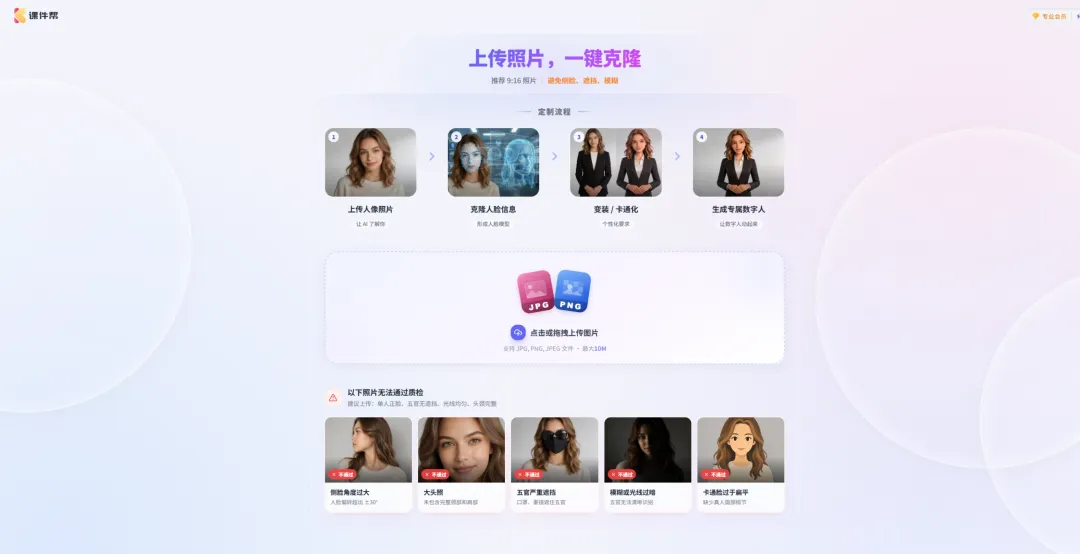
对于大多数语言老师来说,用模板库或者轻度定制是更现实的选择——不是每个人都想把自己的脸数字化,但对那些想建立“个人IP”、想把个人形象沉淀为机构资产的头部讲师来说,专属数字人就是值得的投资。
选定数字人之后,系统会自动根据内容主题匹配讲解背景模板。比如英语口语课的示范场景、语法课的教室背景、日语课的日式场景,选好了就能直接合成视频。
场景匹配这一步,实际上是整个流程里最能体现课件帮“懂教学”的地方。不是让你从一个通用视频模板里慢慢挑,而是AI根据你的学科和内容风格直接推荐合适方案。
04 组合拳:一句话说清4次操作,1小时产出系列微课
现在,最关键的环节来了——声音复刻和数字人形象链接在一起,怎么变成一套完整的工作流?
以一位英语机构的老师为例,她的目标是制作一个单元配套的5节口播微课。整个流程大概是这样的:
🌟1. 进入课件帮首页,上传她已经做好的PPT课件(或直接输入本单元的教学主题)。
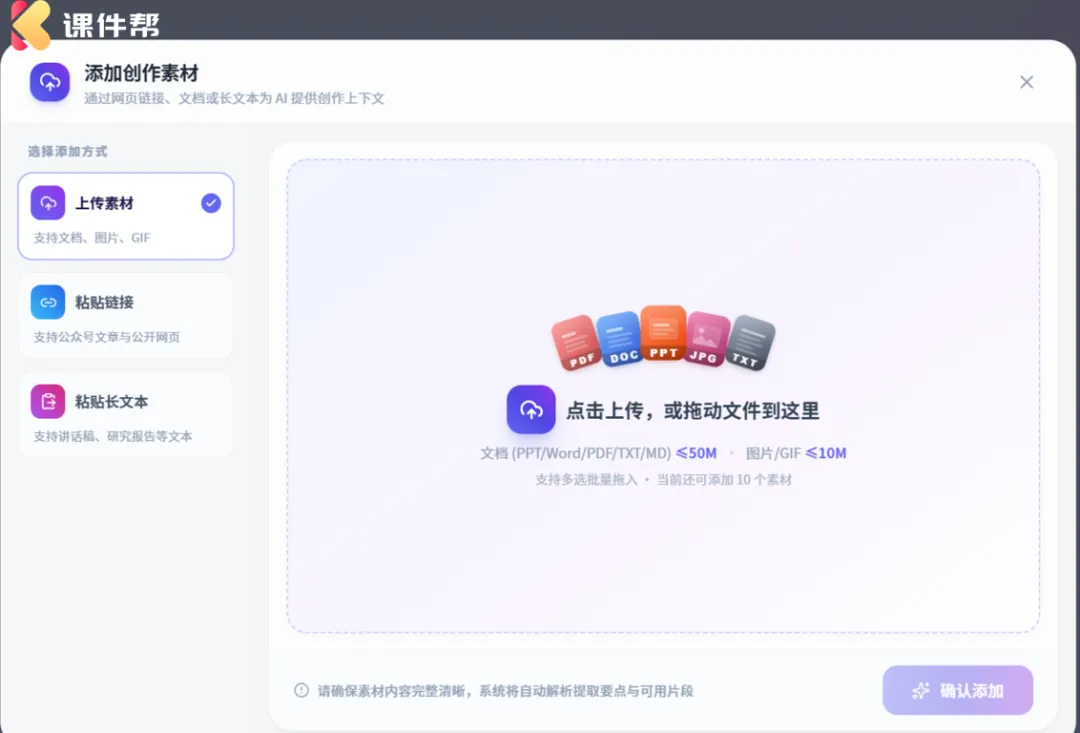
🌟2. 开启「AI解析生成文案」,系统自动根据PPT内容生成口播讲稿。不需要你逐字逐句写,AI先把初稿搭好,你只需要在上面改改自己上课时的口语习惯、加两个和学生互动的小笑话,润色一遍就行。
🌟3. 在“数字人”设置里选择已经定制好的形象,语音选择“我的音色”(之前克隆好的)。
🌟4. 预览一遍,调整字幕位置、背景,导出。
这个过程,一节约10-15分钟。一整套5节的单元微课,一个下午就能全部搞定!
我算过一笔账:以前这位英语老师录一个单元的微课,至少需要花2天时间:写稿半天、录制半天、剪辑返工半天,还得搭进去周末时间。现在是:文案AI生成+老师润色40分钟,数字人合成视频总耗时加起来不到1小时。
对比维度 | 传统录制方式 | 课件帮声音复刻+数字人定制 |
出镜准备 | 化妆、布光、找机位 | 无,数字人代劳 |
口播文案 | 手写逐字稿3小时 | AI生成+润色40分钟 |
剪辑工作 | 剪映剪辑1小时 | 系统自动匹配字幕、转场、背景音乐 |
5分钟微课总耗时 | 约5小时 | 约10分钟 |
个性化程度 | 真实但辛苦 | 你的声音+你的虚拟形象+AI效率 |
这组对比不是夸大,而是我实测下来的真实体感。课件帮把语言的“口播感”和数字人的“视觉感”做了组合,老师只需要输出自己的讲课思路和语言习惯,剩下的交给机器。
05 成本账:算一笔让教务主任都心动的账
咱们不谈虚的,直接算钱。传统外包一条专业微课的行情价在300-1500元不等(看质量和制作公司),还得排队等排期。而课件帮做一个5分钟的视频,仅需消耗250个课件帮算力,折合下来成本大概是原来的十分之一左右。
说句实在话,成本降低幅度不会低于90%。这是2026年教培行业降本增效里最清晰的一笔账。
更重要的是,传统方式制作一套系列微课往往要按月计算交付周期,而课件帮把产能拉到了“今天出稿、今天出片”的级别。
机构想要维持“每天早上8点发一条口语带读视频”的日更节奏,传统录课模式基本不可能长期坚持,但现在有一个老师的数字人+声音模型,就能持续不断地产出。这背后是内容生产力的数量级提升。
06 能不能更“个性化”?这组合还能用到哪些场景
你可能想问:声音复刻和数字人定制的组合,除了英语,能做其他语言吗?
从课件帮的技术架构来看,它支持的远不止英语,法、日语、韩语等语言的口播文案生成也完全没问题。尤其适合语言机构的这些场景:
- 每日口语跟读视频:数字人出镜示范口型,你的声音带读,学生跟着模仿。
- 语法微课系列:不用出镜,PPT配合你的声音讲解,数字人坐在旁边做点缀。
- 课后复习短视频:把课堂重点浓缩成3分钟快闪视频,发到班级群,家长和学生都爱看。
- 机构品牌宣传口播:校长的虚拟形象配校长的声音,讲述机构教学理念。
课件帮的优势在于,它不是把声音和形象绑定成一套死配置,而是把“你的声音”和“你的形象”都做成了可以随时调用的资产。今天你录好了声音,明天你换了新发型想做新形象,再定制一次就行;想改课程风格,换一个背景模板就完事儿。
对于想建立个人IP的头部老师来说,这个组合也意味着:即使你一天只有1小时空闲,你的数字分身也能一天24小时帮你在线上“讲课”。内容资产由此实现了规模化积累,而不是靠个人精力硬撑。
---常见问题
问:课件帮声音复刻需要录多久的音频?
-老师说句实在话,录5分钟左右的清晰语音样本就够用了。系统会分析你的音色、语速、停顿习惯,之后数字人播报就能用你的声音讲课,学生听起来像你本人在上课。
问:定制数字人形象麻烦吗?需要什么素材?
-不麻烦。你上传一张正面照片或一小段视频素材,课件帮就能生成专属虚拟形象。如果不想用真人形象,模板库里也有大量适合教学场景的数字人形象可选,直接换上去就行。
问:用课件帮做口播微课,一节5分钟的视频实际要花多少时间?
-从导入PPT或输入主题开始,到AI生成口播文案、匹配模板、合成数字人视频,熟练后大概10分钟就能导出一节5分钟的微课。算力成本只需要250个课件帮算力,相比传统录制大幅降低。
问:声音复刻和数字人定制组合,适合哪些教学场景?
-非常适合语言培训机构的每日口语跟读、语法精讲、课后复习类微课。老师不用出镜也能批量产出个性化内容,学生看到的是老师的数字分身,听到的是老师自己的声音,亲切感和代入感都在。

