40 份 Word 教案,怎么一次抽成一张表
- 2026-10-24 17:23:49
期末收教案,40 份。
要把每份的课时数、教学目标条数、教学环节数摘出来,做成一张汇总表交给教研组。
一份一份点开,找到那几行,复制,粘到表里。40 份下来,一上午就没了。
这件事 Python 能干,但比前两篇都要费点劲。
前两篇是往文档里装东西。你手上有一份模板,你知道第几段该写什么,往里填就行。
这一篇反过来。文档是别人写的。
先看看素材长什么样
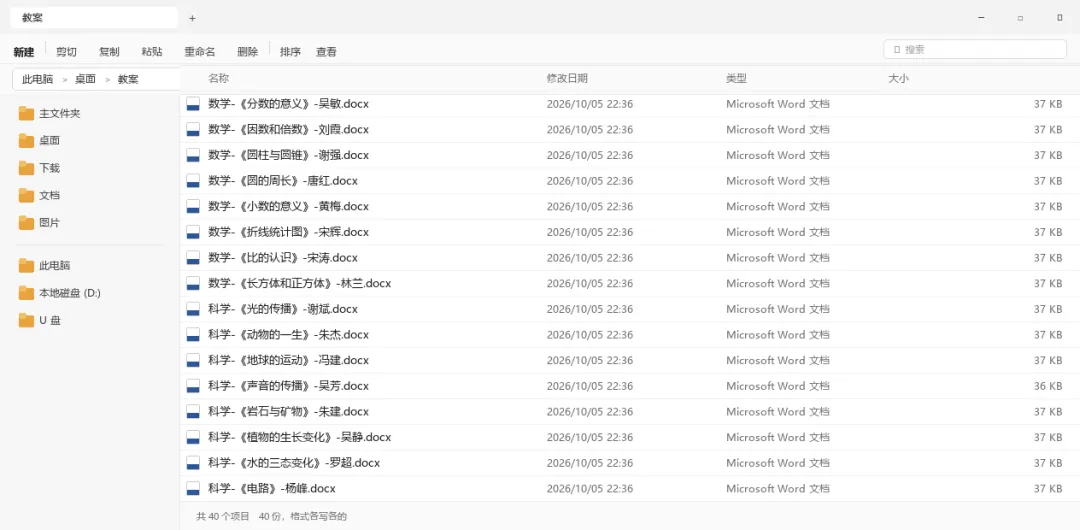
40 份教案躺在一个文件夹里,名字是按要求的格式起的
文件名有统一的格式:学科、课题、教师。收的时候就交代过,省了不少事。
但打开看,里面的写法就不一样了。
所以写代码之前先做一件事:拿几份出来,把里面的结构打出来。脚本里留了个 --peek 开关,只看结构,不抽取。
段 [Heading 1] 《草原》教学设计
段 [Normal] 学科:语文 授课教师:吴超 授课班级:五(2)班
段 [Normal] 一、教学目标
段 [Normal] 1. 有感情地朗读课文,背诵自己喜欢的段落。
段 [Normal] 2. 认识 8 个生字,会写 12 个生字。
段 [Normal] 四、教学过程
表 7 行 3 列 表头 ['教学环节', '时间', '主要活动']
要抽什么,一眼就看出来了。
整件事分 4 步走。
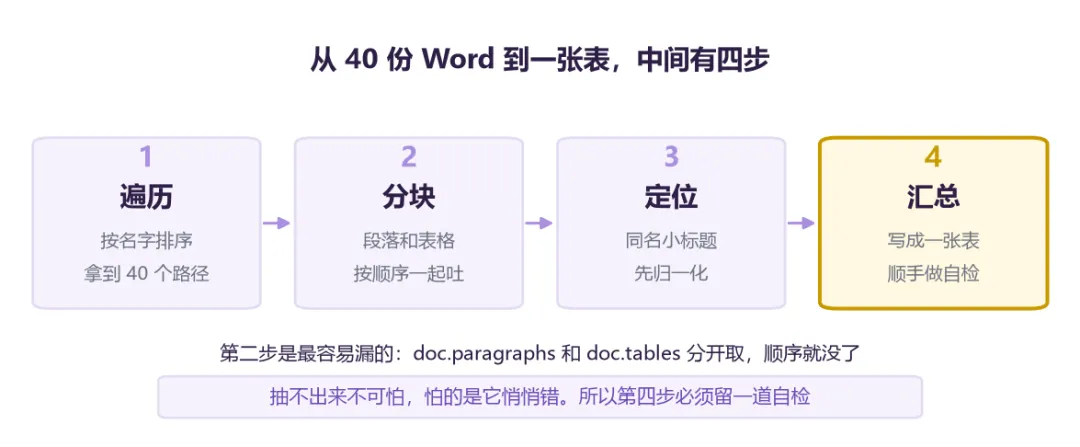
从 40 份文件到一张表,中间有四步
第一步:拿到 40 个路径
用 pathlib 一行就够。
files = sorted(ROOT.glob("*.docx"))
sorted 不能省。文件系统吐出来的顺序是不固定的,不排一下,每次跑出来的前 5 行都不一样,核对起来很烦。
那个 --peek,不多余
十几行代码,只打印文档结构,看着像白写的。
第一次跑就发现了两件事:小标题有 4 种写法;教学过程不是段落,是一张表。
要是没这一步,照着自己脑子里的模板写定位规则,跑完抽出来一堆空的,再回头一份份翻文档找原因,来回要折腾好几遍。
解析类的活儿,先看数据再动笔,省的不止一点。
第二步:把顺序找回来
这一步是本篇最容易踩的坑。
打开一份文档,python-docx 给了你两个属性:doc.paragraphs 和 doc.tables。
段落一个列表,表格一个列表。看着挺全。
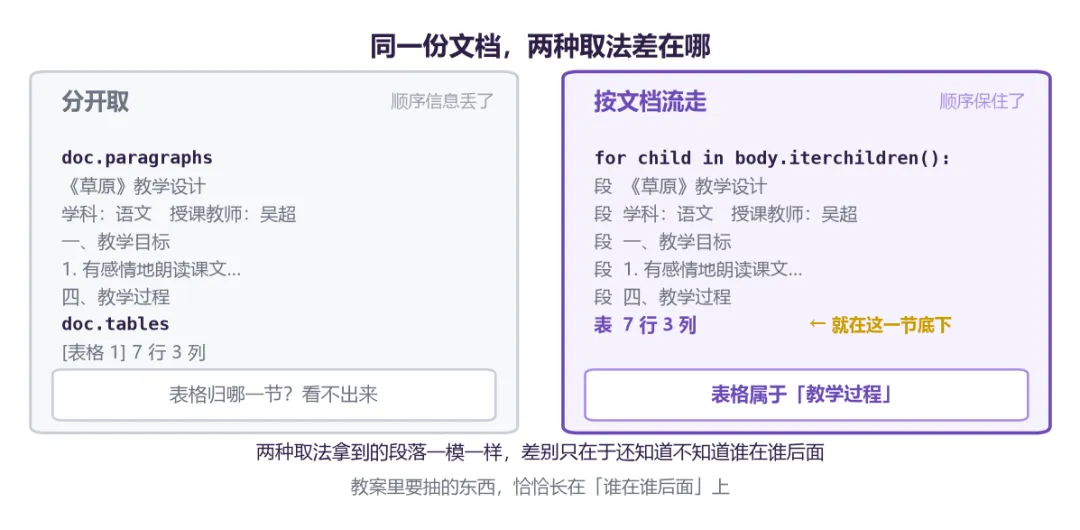
两种取法的差别
问题在这里:两个列表是分开的。
你在段落里找到了「四、教学过程」这一行,也在表格里找到了那张 7 行 3 列的表。
可这张表在段落的哪个位置?看不出来。
教案里要抽的东西,恰好就长在「谁在谁后面」上。「四、教学过程」这一行后面跟的那张表才是教学过程,前面那张可能是课程安排表。
python-docx 做这两个属性,是为了让你少写代码。代价就是位置关系丢了。
想拿回来,得绕开它们,直接读文档的底层。
一份 Word 文档在底层是一个 body,里面按真实顺序排着一个个元素。段落是 w:p,表格是 w:tbl。
顺着走一遍,顺序就回来了。
def iter_blocks(doc):
body = doc.element.body
for child in body.iterchildren():
if child.tag == qn("w:p"):
yield "p", Paragraph(child, doc)
elif child.tag == qn("w:tbl"):
yield "t", Table(child, doc)
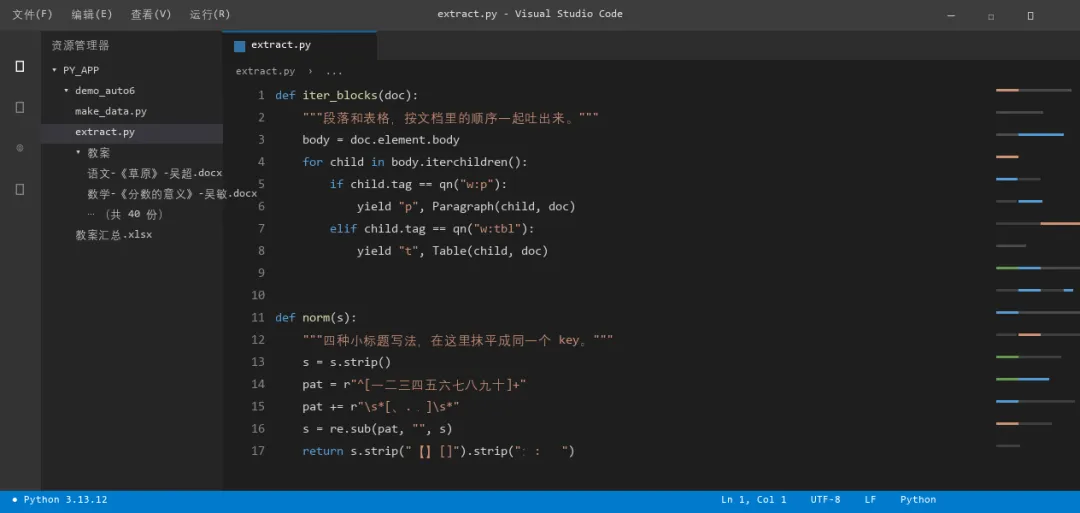
分块和归一化,本篇的两个核心函数
吐出来的就是一个有序序列,段落和表格混在一起,谁在谁后面一目了然。
图里上半段是分块用的,下半段那个 norm() 是接下来要讲的。
第三步:把标题抹平
顺序解决了,接下来是定位。
目标很明确:找到「教学目标」那一节,把它底下的几条抄下来。
可 40 份教案里,这 4 个字有 4 种写法。
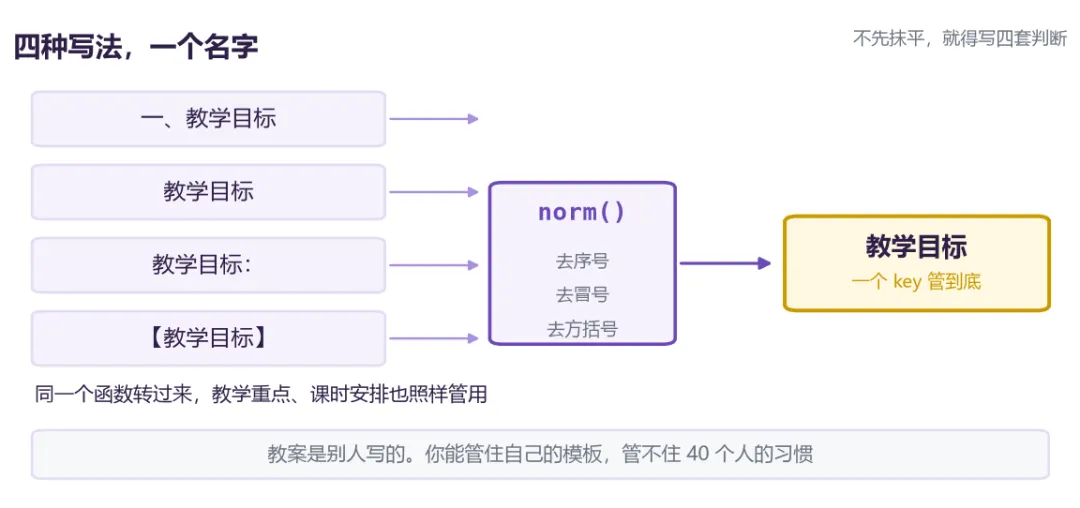
四种写法,归一化成一个 key
要是写 4 个判断分别处理,代码会又长又脆。而且今天 4 种,明天可能变成 6 种。
做法是加一层归一化。不管原样长什么样,先抹成同一个 key,再拿这个 key 去找。
def norm(s):
s = s.strip()
pat = r"^[一二三四五六七八九十]+\s*[、..]\s*"
s = re.sub(pat, "", s)
return s.strip("【】[]").strip(":: ")
「一、教学目标」去掉序号,「教学目标:」去掉冒号,「【教学目标】」去掉方括号,三种最后都落到「教学目标」上。
同一个函数换个关键词,管「教学重点」「课时安排」也一样。
教案是别人写的。你能管住自己的模板,管不住 40 个人的书写习惯。
课时那一节的写法也不统一。2 课时、共 2 课时、两课时、2课时,又是 4 种。
抽取的时候先找阿拉伯数字,找不到再认中文数字。要注意「两」这个字,中文里说「两课时」比说「二课时」自然得多,字典里漏了它就会少抽好几份。
第四步:汇总,顺手自检
到这一步其实没什么难度了,把抽到的东西塞进 DataFrame。
课时那一列有个小地方要处理。40 份里有 1 份没抽到课时,这一列就会从小整数变成小数,3 显示成 3.0。
加一句 df["课时"] = df["课时"].astype("Int64") 换成可空整数就正常了。缺的那一格显示
跑完 40 份,不到 2 秒。
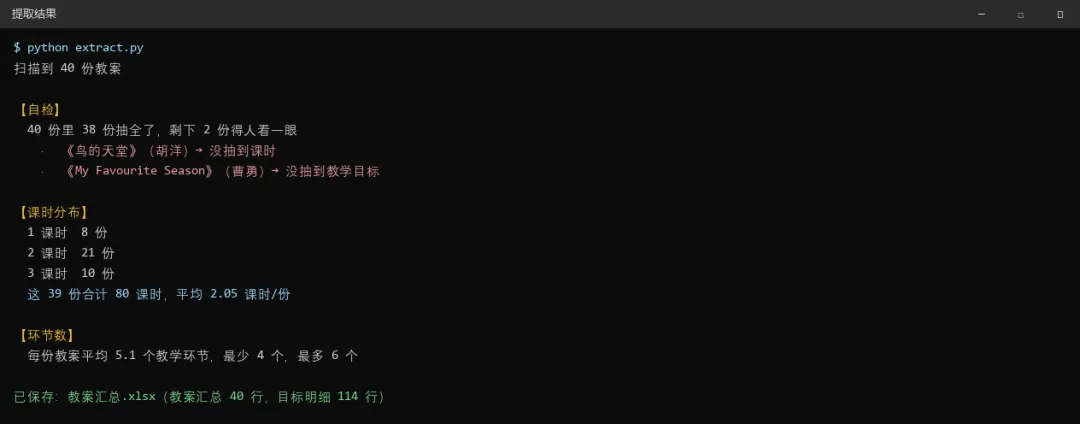
终端输出
有一种写法藏在表格里
前面说的都是按段落找。但教案里还有一类写法,把内容放进表格。
脚本里留了一手:如果「教学目标」那一节里没有正文,就去这一节底下的表格里捞。捞出来的格子按行读一遍,就当成几条目标。
这招救回了大部分情况。但有一份还是没救回来。
那份教案里,连「教学目标」这 4 个字都不在正文里,被写进了表格的第一格。脚本从头到尾没见过这 4 个字,自然找不到那一节。
所以抽取的规则不可能提前想全。你不知道下一批教案会长成什么样。
这也是为什么自检比规则重要。
抽完不算完
真正要紧的是最后那道自检。
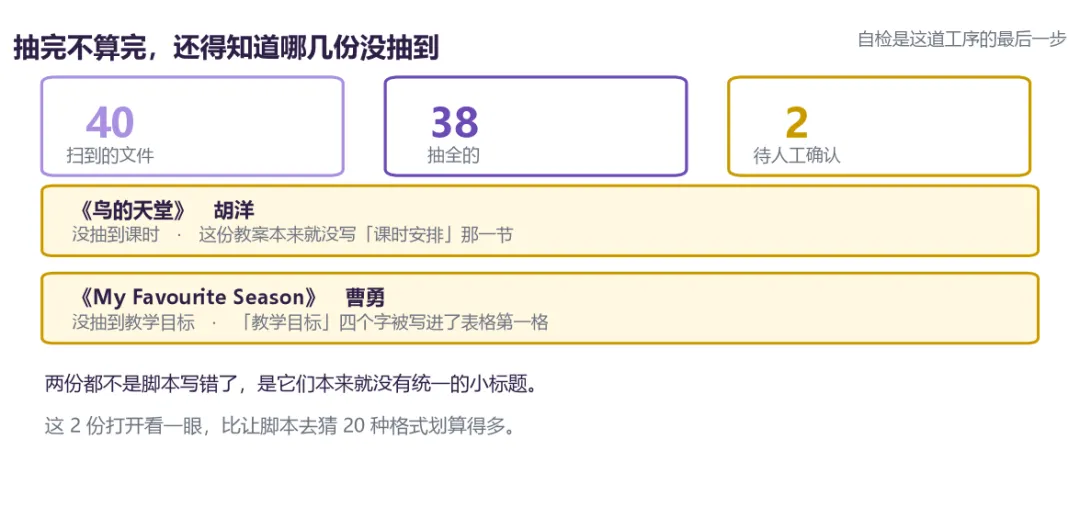
40 份里 38 份抽全了
38 份。剩下 2 份得人看一眼。
一份是《鸟的天堂》,没抽到课时。打开一看,这份教案本来就没有「课时安排」那一节,写的人把它漏了。
另一份是《My Favourite Season》,没抽到教学目标。「教学目标」这 4 个字被写进了表格的第一格,正文里压根没有这个小标题。
两份都不是脚本写错了,是它们本来就没有统一的小标题。
这 2 份打开看一眼,比让脚本去猜 20 种格式划算得多。
自检的判据也很朴素:课时必须是个数字,目标至少 2 条,班级不能是空的,缺哪样就记一笔。
这几条不保证抽出来的一定对,但能保证漏掉的一定被看见。
明天又收 40 份,要改哪里
这套脚本不是一次性的。
下学期再收一批教案,可能要动的地方只有 3 处:文件名格式变了,改那行正则;多了一两种新标题写法,往 SECTIONS 里加一条;目标的关键词换了,改 GOALS。
数据源和规则分开写,规则集中放在文件开头,改起来就快。
要是把关键词和判断散在各个函数里,3 个月后自己都找不齐。
表长这样
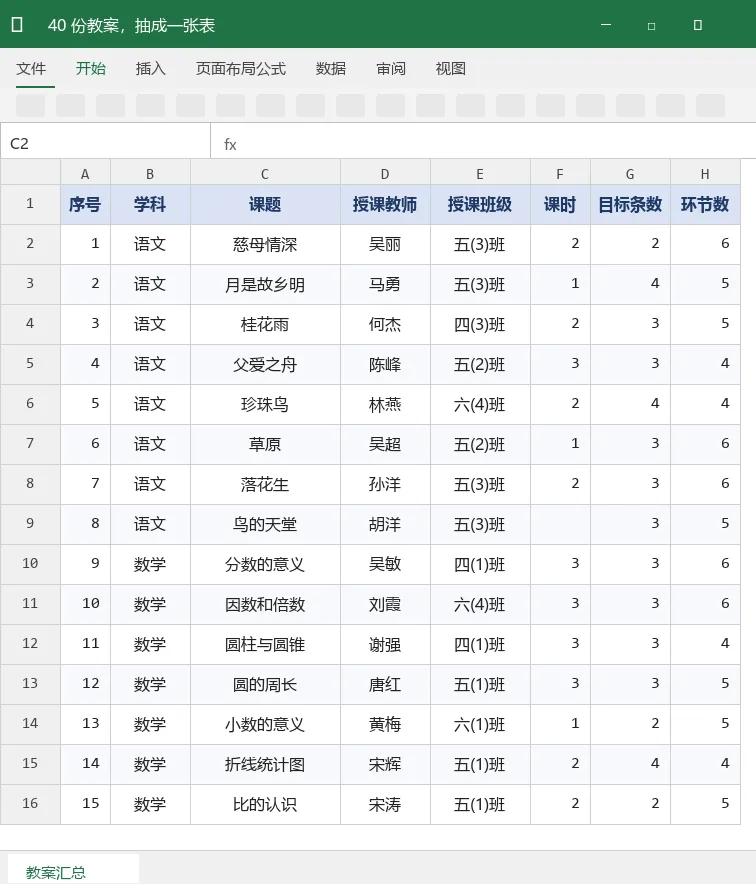
抽完的汇总表,空的那格就是没抽到的那份
抽出来的数据本身也有点意思。
课时分布上,2 课时最多,21 份;1 课时 8 份,3 课时 10 份。合计 80 课时,平均 2.05。
按学科分开看,差别就出来了。数学最舍得花时间,平均 2.38 课时;语文最省,1.86。同样一节 40 分钟的课,语文老师更爱一两节讲完。
114 条教学目标,平均每份 2.85 条。教学环节平均 5.1 个,最少 4 个,最多 6 个。
这几组数字放在一张表里,比翻 40 份文档快得多。
装和掏,难的地方不一样
前两篇是往文档里装东西。装的时候,你放没放进去,自己心里清楚。
这一篇是往外掏。少掏了一部分,你不会知道。
所以脚本最后必须留一道自检,把没抽到的挑出来,摆在你面前。
还有一层。这次能从文件名里直接拿到学科和教师,是因为收的时候就规定了命名格式。要是哪天收上来的名字五花八门,这两项也得从正文里找,难度再翻一倍。
抽取的活儿,麻烦的从来是别人给的格式不统一。
下一篇换个对象。Word 讲完了,接下来是 Excel。

