课件到数字人讲课视频 秘塔ai放大招了
- 2026-11-07 20:44:52
课件到数字人讲课视频 秘塔ai放大招了
在两年前就一直使用秘塔ai,那个时候就是上传自己的ppt,秘塔ai生成视频进行讲课,可以自己选择讲课的方式,真的非常好用。
最近打开秘塔AI的“今天学点啥”首页时,第一眼没看出什么变化。
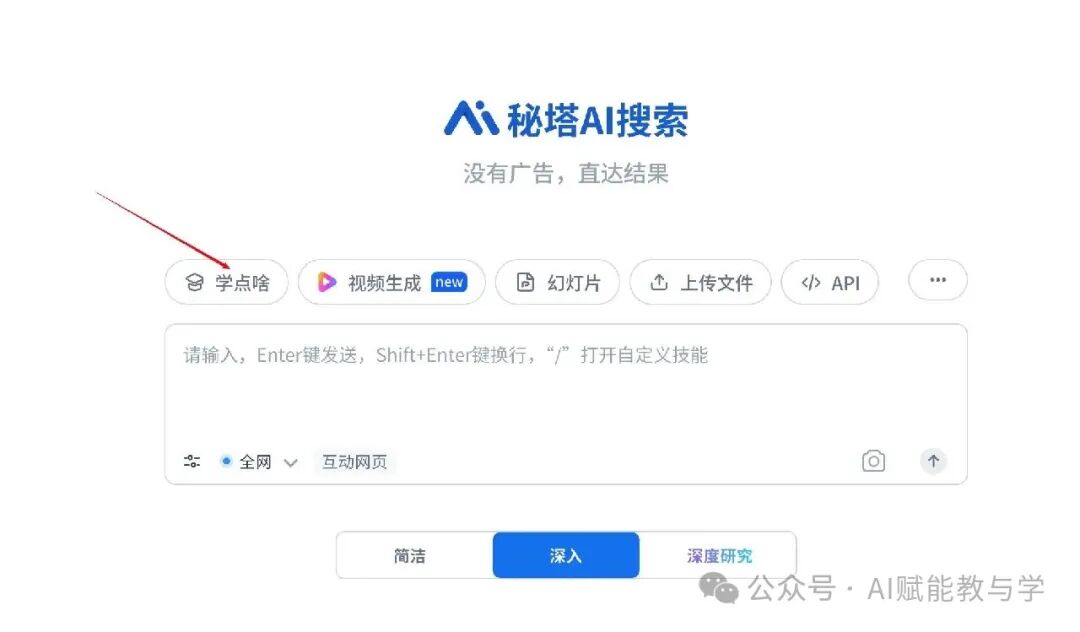
进入今天学点啥页面再看一遍,才发现“讲题”前面多了一个小小的入口:“学点啥 New”。它指向的不是课程列表,而是一个独立的讲课视频制作页。
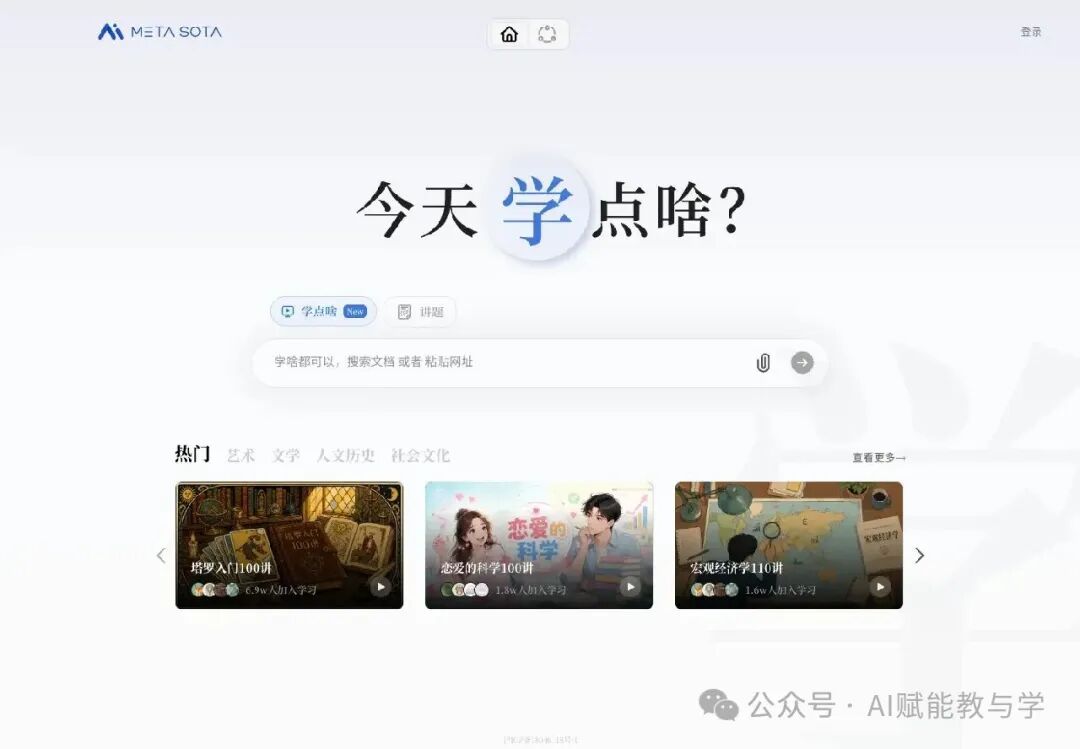
图注:metaso.cn/study 首页,“讲题”前新增“学点啥 New”入口
我把入口和制作页都点了一遍。先给结论:功能已经上线,流程也做得比较完整,但它更像一套“课件自动成片工作台”
这次上线的,到底是什么
[秘塔AI“学点啥”]这个新入口,页面上写的说明是“上传课件或输入文本,制作讲课视频”。
点进去以后,界面分成几个区域:上传课件、设置语言和分辨率、添加数字人形象、选择参考音频,音频是选填,最后点“开始制作”。
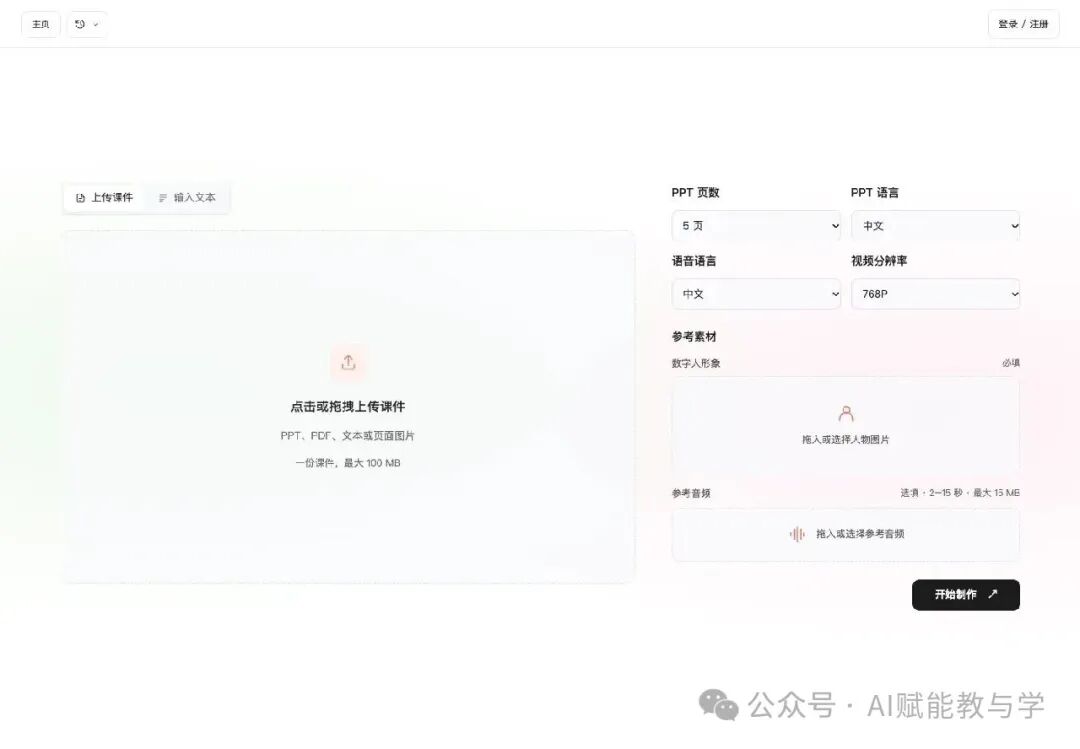
图注:metaso.cn/lecture 讲课视频制作页
能传的内容比原文提到的一两种文件更多:PPT、PDF、文本和页面图片都可以,单份课件最大 100 MB。
数字人形象是必填项,需要上传一张人物图片。参考音频是选填项,建议 2–15 秒,最大 15 MB。
页面还提供中文、英文选择,分辨率为 768P、1080P、2K 三档。这个细节挺重要:如果只是做班级群里的预习视频,没必要一上来就追高分辨率;用于正式展示,再把画面规格拉满。
它怎么把一份课件变成讲课视频
从制作页看,操作顺序并不复杂:
上传 PPT、PDF、文本或页面图片; 上传一张数字人形象照片; 需要定制音色时,再传一段短音频; 选语言、分辨率和课件页数,开始制作。
需要先准备的,不是复杂软件操作,而是三样素材:一份结构清楚的课件、一张可用的人物图、一段能代表讲课人声音的音频。
这也是它和传统录课最直接的差别。以前老师要把镜头、灯光、提词器、录音和剪辑凑齐,现在这些环节被收进一个网页里。
上案例看实际效果
我选择了一门人机交互课程的一节ppt进行上传,上传后点击开始制作。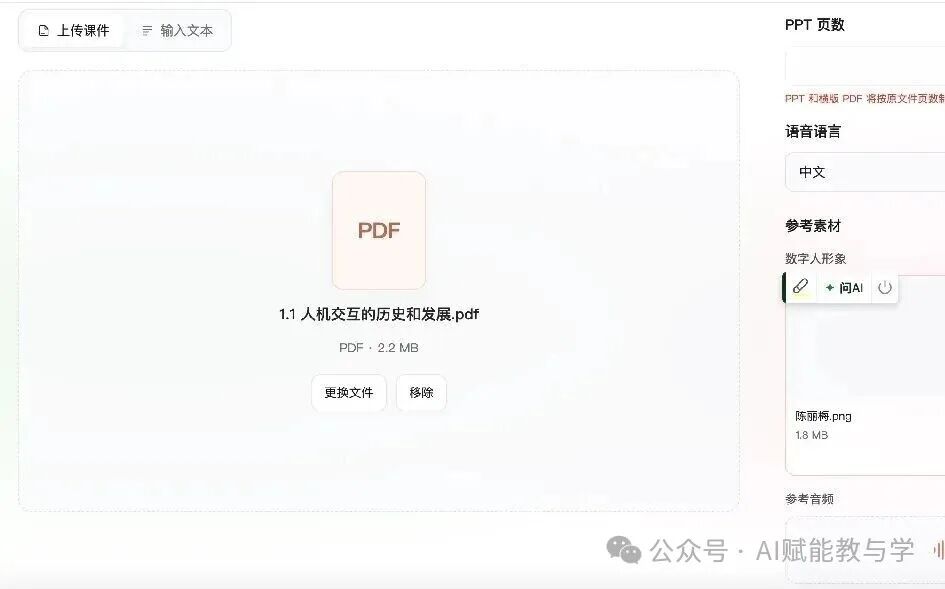 首先是解析 然后是逐页生成视频,这里需要点时间等待运行完成。
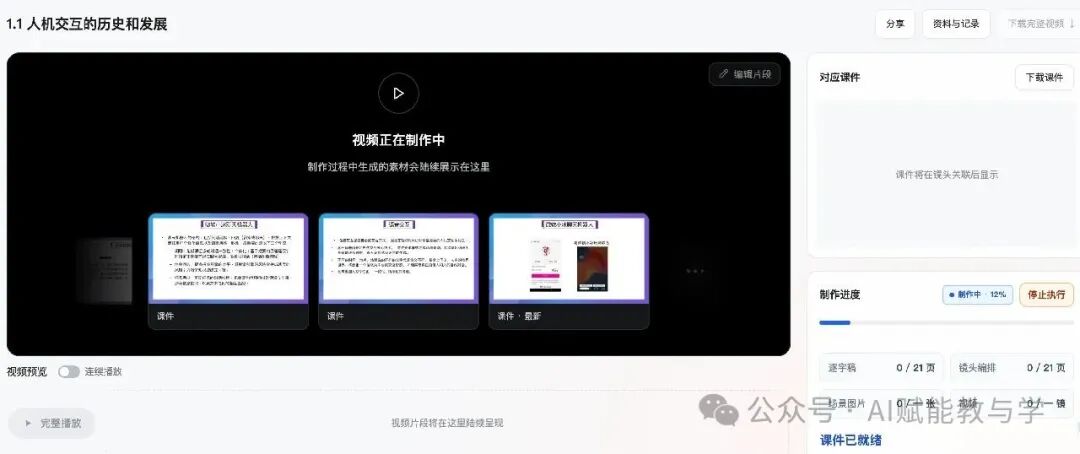 来看效果,这个效果真的是惊艳到我了,不仅具有ppt的动画,还添加了一些交互的效果,这个交互效果和原ppt相互辉映,效果非常惊艳。
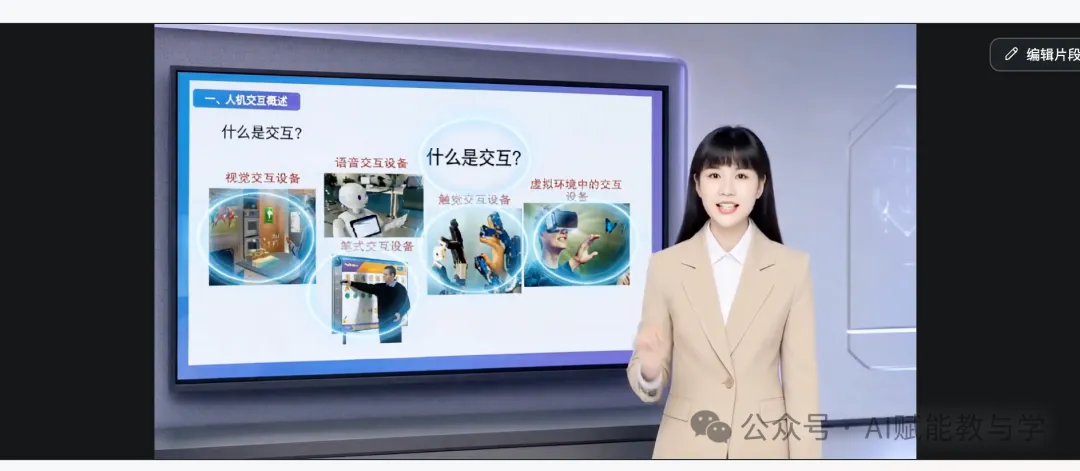
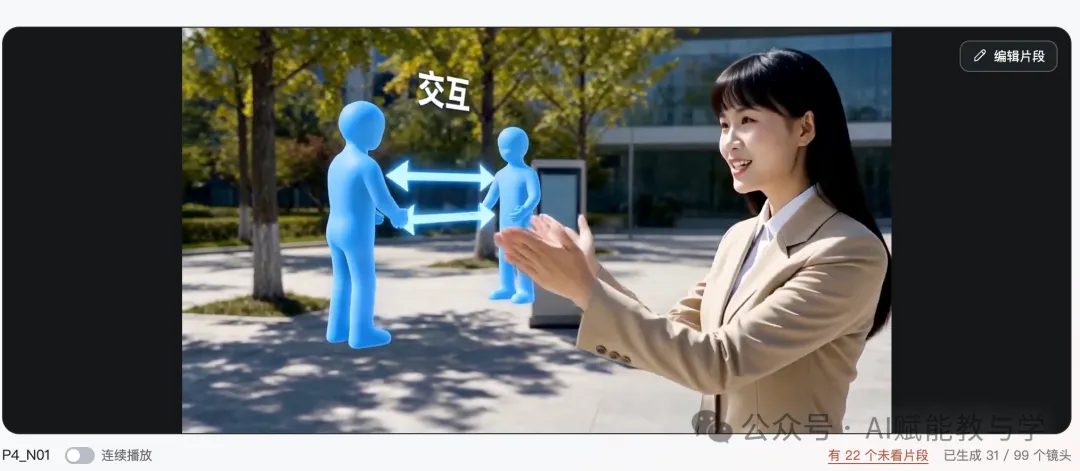
若是哪里不合适,还可以但片段进行修改,非常方便,这波操作秘塔也惊艳到我了
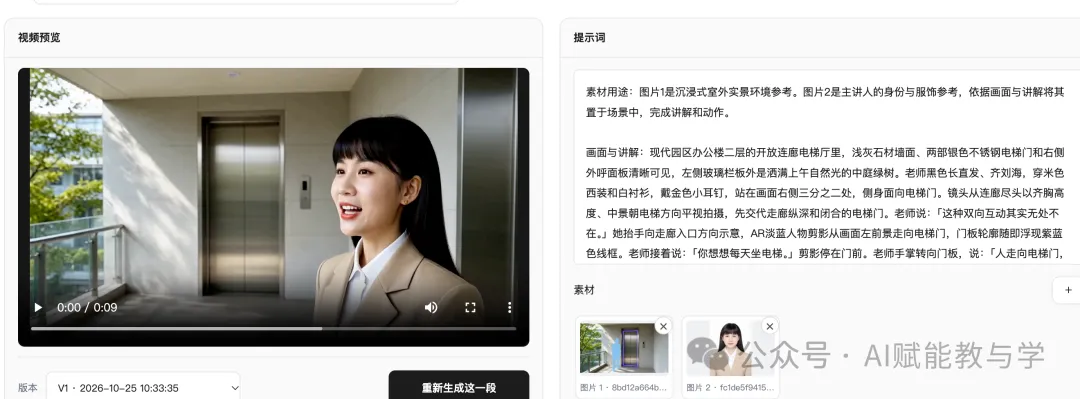
但单条样片只能证明上限,不能证明每一次都能稳定达到这个效果。人物素材清不清楚、课件页面密不密、讲稿是否适合口播,都会直接影响最后的结果。
老师为什么会需要它
录课这件事,麻烦的地方往往不在讲课本身。
有人不愿意出镜,有人一面对镜头就忘词;有人会讲,却被剪辑时间卡住;还有人课件已经改了三版,录好的视频又得全部重来。
数字人讲课解决的,正是这些重复劳动。
老师仍然是教学设计者:决定讲什么、怎么讲、哪里举例、哪里停下来解释。数字人接手的是标准化录制和成片呈现。
这个分工比“AI替老师上课”准确得多。它先省掉的是反复出镜和重录,教学判断并没有被替掉。
拿来准备微课、课程预习、培训材料或者知识点补充,都算顺手。放进正式教学平台之前,仍然要有人把讲稿、术语、例题和画面逐项核对一遍。
先别急着谈“替代”
看到数字人越来越像真人,很容易顺手往“以后老师是不是不用录课了”上想。
问题在于,录课只是教学链条中的一段。
数字人能按稿讲,却不会自动知道一个班的学情;能展示课件,却不一定能接住学生临场提出的问题;能生成标准化的声音,却不能替老师承担专业判断。
所以它更适合放在“生产工具”的位置,而不是“教师替身”的位置。
还有一个容易被忽略的边界:人物照片和声音都不能拿来就用。
如果是自己的形象和声音,要保留清晰的授权和素材来源。如果是同事、学生或网络人物,没有明确授权,就不应该上传制作。正式参赛、公开发布或商业使用时,还要先看活动规则对AI生成内容、署名和披露的要求。
“技术能做”和“规则允许”之间,中间还隔着授权、合规和学术诚信。
这类产品接下来比什么
数字人播讲并不是今天才出现的能力。市场上已经有不少产品能把课件和虚拟形象合成为讲解视频,教育也是它们最常见的应用场景之一。
过去大家比较的是“像不像人”。往后,光靠一张更逼真的脸,很难拉开差距。
影响老师会不会长期使用的,是另外几件事:
能不能根据课件自动写出像老师说话、而不是像说明书的口播稿; 能不能和学校现有的课程平台、题库、资源库接上; 出了问题后,能不能只改一页课件、一句讲稿或一个片段,不必整条重录; 学生端能不能提问、反馈,而不只是被动看完一条视频。
从“替代老师出镜”走到“提高老师产出”,竞争方向已经变了。

